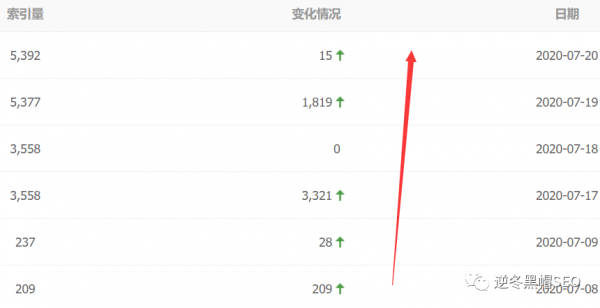
robots.txt只有几百字节,写错一个字符的影响比整站改版还大。最常见的错法是想禁止一个目录,写成了Disallow: /,只有一根斜杠。这一行等于告诉所有爬虫:整站都不要抓。想禁目录,斜杠后面必须带路径,比如Disallow: /tmp/。想禁单个文件,就写完整路径。另一个高频错误是冒号用了全角,或者行首多打了空格。爬虫解析失败时,有的按无限制处理,看起来没挡,有的会把这条当成无效。结果就是从某天起收录量一路往下掉,而站点本身什么都没改过。
规范里用的是路径前缀匹配,一根斜杠就能卡掉全站,原因就在这套规则上,斜杠匹配所有以斜杠开头的路径,也就是全站。少写几个字符,匹配范围就从某个目录变成了整个站点。
Disallow: /和Allow: /同时存在的时候,看着像放开了,实际要看哪条更长。匹配规则取最长的那条,两条一样长时通常Allow优先。各爬虫的实现不完全一致,别指望这个。要么只写Disallow,要么把Allow写到更具体的路径上。两条规则冲突的时候,不同爬虫的取舍不一样,靠它不如靠写法清楚。
星号和美元符号属于扩展语法,主流爬虫支持,不是所有爬虫都认,通配符和结尾符是另一片雷区。写Disallow: /*.php$想挡动态页,容易把正常页面一起挡掉。带参数的URL,用Disallow: /*?更稳妥。
robots.txt返回200但正文是HTML,等于没写,状态码比内容更容易被忽略。很多站点的404页面配了重写规则,所有不存在的路径都返回200,robots.txt也被一起吞掉。返回5xx时,爬虫会当成服务器暂时故障,降低抓取频率甚至暂停一段时间。只有4xx才被理解为没有限制。改完先看状态码,再看内容,两样都对了才算配好。
搜索资源平台里有robots测试工具,能直接看某条URL会不会被挡。自己用curl拉一遍,看返回头和正文前几行,也能发现不少问题。测试工具给的是解析结果,curl给的是实际响应,两边一起看最稳。改完靠这两个验证,别靠猜。
Disallow只表示不让抓取,不等于不进索引,这一点经常被弄混。别的站链过来,页面照样可能出现在结果里,只是没有摘要。这种页面在结果里的表现是没有描述、标题取自外链文字,比彻底消失更难察觉。
真要下线的页面,得用noindex,或者直接返回410。robots.txt和noindex别同时用。挡住抓取之后,爬虫读不到noindex,两边互相打架。想让它彻底消失,还是得让页面自己告诉爬虫不要索引,或者干脆返回410。
申请创业报道,分享创业好点子。点击此处,共同探讨创业新机遇!