AI算力正在覆盖从终端设备、边缘节点到云端数据中心的多层级应用。不同场景对芯片的功耗、算力和部署方式各有要求,也需要算力产品具备灵活扩展能力。如何让通用算力适配多样化场景,并支持从单芯片部署到互联扩展,正成为产业关注的方向。
11月2日,2026年“中国芯”优秀产品征集活动评选结果揭晓。合肥芯动力科技有限公司自主研发的RPP-R8/AE7100E通用并行计算芯片荣获“芯火新锐”奖,体现了业界对其技术创新与产品发展的认可。
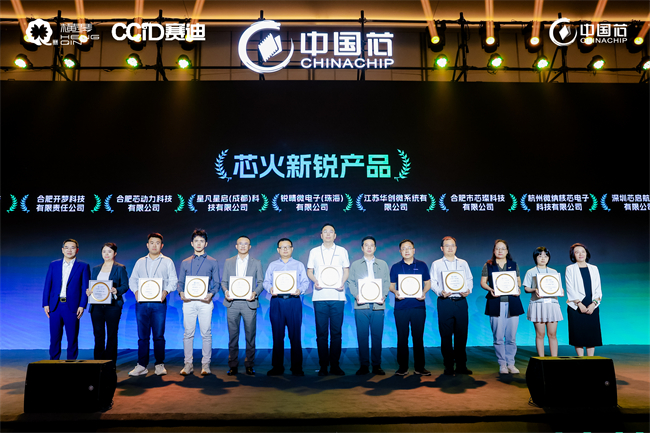
“中国芯”优秀产品征集活动由工业和信息化部指导、中国电子信息产业发展研究院主办,自2006年创立以来持续关注集成电路领域的创新成果。“芯火新锐”奖聚焦具有成长潜力、具备产业化能力的新锐产品与力量,是观察国产芯片创新活力的窗口之一。
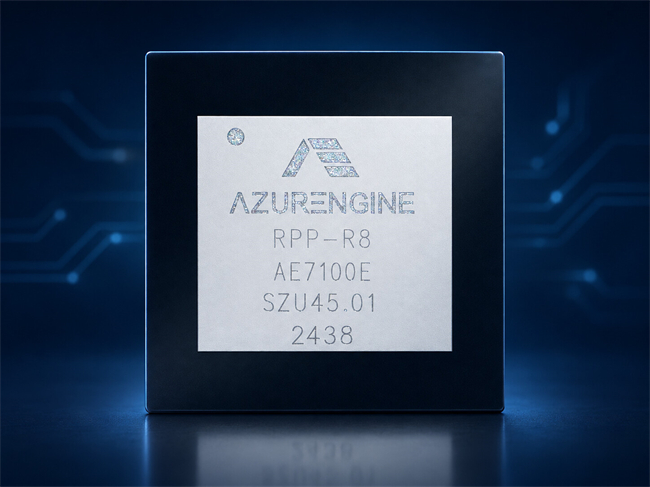
AE7100E是首款基于芯动力自主知识产权的RPP(可重构并行处理器)架构打造的高能效通用并行计算芯片,采用14nm工艺,典型功耗<15W,提供32TOPS峰值算力,芯片可用于边端侧设备,满足设备侧智能应用的算力需求;也可通过芯片互联扩展算力,应用于云端场景,为不同层级的AI部署提供通用并行计算支持。
在软件生态方面,AE7100E支持PyTorch、TensorFlow等主流AI框架与ONNX模型格式,原生兼容CUDA,已完成DeepSeek、Qwen、Llama等主流大模型的适配,并支持x86与ARM双架构平台,显著降低模型迁移与应用开发成本。
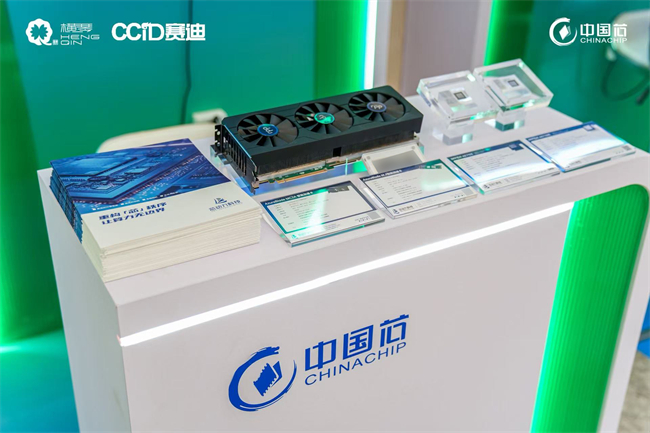
基于AE7100E,芯动力还推出了AzureBlade M.2与AzureBlade MC2A智能加速卡。M.2加速卡采用标准接口,可为AI PC、NAS等设备提供端侧算力;并已完成AI PC产品供货;集成12颗AE7100E芯片的MC2A加速卡面向服务器、智慧城市等算力需求较高的场景,并已在医疗基因测序等场景完成方案落地。大会期间,公司展示了芯片及两款加速卡,并与行业客户和合作伙伴交流产品应用。
从芯片架构到加速卡产品,再到行业方案,芯动力持续推进RPP技术研发与应用探索。面向未来,芯动力将持续以自主RPP架构为核心,深化芯片研发、软件生态与行业应用协同,携手产业伙伴拓展边缘通用算力的应用边界,为数字中国建设注入自主可控的算力动能,以高水平科技自立自强支撑高质量发展。
申请创业报道,分享创业好点子。点击此处,共同探讨创业新机遇!