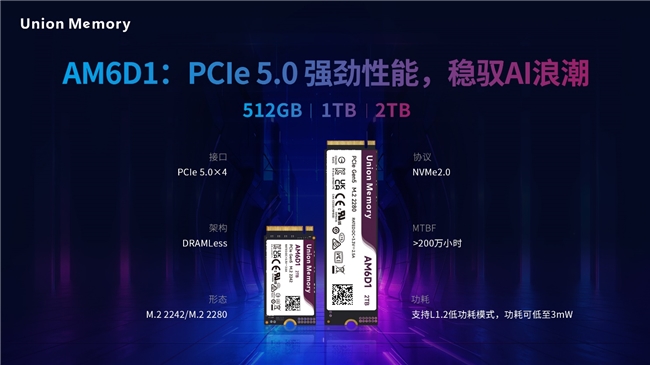
AI 应用的爆发正推动终端硬件全面迭代。 NVIDIA 最新推出搭载统一内存(UMA)架构的 RTX Spark 超级芯片,让终端 PC 真正具备流畅运行千亿参数大模型的能力。然而,从超强算力到落地体验,SSD始终是难以绕开的关键一环——模型加载、版本切换、高频IO交互等环节对存储的带宽、延迟及可靠性均提出了严苛要求。AM6B0凭借满血性能、高可靠性及与软硬件的深度协同,成为UMA时代大模型存储的“标配”之选。

实测验证:千亿大模型加载仅需14.6秒
为验证AM6B0在AI场景下的真实性能,忆联测试团队基于搭载NVIDIA GB10芯片、128GB UMA内存及DGX OS(Ubuntu)的测试平台,对2TB容量的AM6B0产品进行了实测。结果显示,AM6B0冷启动加载Qwen3.5-122B大模型仅需14.6秒,平均读取带宽高达5.55GB/s。国内一线友商同级别产品 加载耗时16.8 秒,带宽仅4.82GB/s 。AM6B0读取带宽领先约15%,加载时间缩短逾13%,差距显著。这一优势绝非微小增量,对于高频开展模型微调和推理测试的 AI 工程师而言,每一次加载的效率提升,将在日常反复操作中形成客观的规模效益,大幅削减无效等待时间,有效释放研发生产力,真正推动AI开发从“可用”迈向“高效”。

强劲性能:7.1GB/s满血释放PCIe 4.0潜能
AM6B0搭载新一代主控与最新代际闪存介质,将PCIe 4.0 带宽潜能发挥至极致。CDM基准测试中,其2TB版本交出顺序读写7100MB/s、6500MB/s,随机读写1000K IOPS、970K IOPS的亮眼成绩——这意味着,无论是大模型冷启动加载,还是高频随机IO交互,AM6B0均能以充沛的带宽储备与迅捷的响应能力从容应对,为AI开发重负载场景提供“即需即达”的存储底气。

在PCMark 10基准测试中,AM6B0 2TB 产品斩获 3933 分的优异成绩,全面领先同档次竞品。这一表现不仅印证了其在AI大模型加载与运行等重负载场景下的从容应对能力,更意味着系统启动、应用加载、日常办公等多元任务均可获得流畅高效的使用体验——从专业创作到日常交互,AM6B0以扎实的综合性能,为用户交付“全场景无短板”的存储体验。

安全可靠:全方位守护数字资产
除极致性能外,数据安全与稳定运行更是 AI 应用的生命线。AM6B0 依托 Unbalance Die 特性、WL Group Retry 机制及精细化重试表策略,构建起从闪存纠错到耐久度强化、再到异常断电防护的多重保障体系——无论是大模型训练中断的突发风险,还是日常高频读写带来的累积损耗,均能从容应对,为每一项研发成果与数字资产筑起坚实防线。

AI浪潮风起云涌,忆联AM6B0以高效、可靠存力补齐算力落地的最后一公里,进一步优化大模型终端运行体验。面向未来,忆联将持续深耕 AI 终端存储赛道,以核心技术的不断迭代为驱动,打磨高性能、高可靠的存储解决方案,为 AI 开发者、内容创作者及高性能计算用户提供专业级生产力工具,持续助推终端 AI 生态加速升级。
申请创业报道,分享创业好点子。点击此处,共同探讨创业新机遇!