文 | 智能相对论
作者 | 叶远风
这届 WAIC 的具身智能,相较去年都在朝着场景进化,如何推进产业落地已经是主旋律,这是好消息。
但是,稍显笨拙的各种秀技,也让人不免对这些演示离真实落地有多远还存在疑虑。
而在“世界模型六小龙巅峰论坛”上,大晓机器人董事长王晓刚丢出一个“具身世界模型第一性原理”,给了行业一个认识具身智能不同的视角或者说导向。
和往年各家忙着晒参数、晒SOTA不同,这次大晓带来的Kairos 3.1开悟世界模型,连同整套数据、方案、生态布局,试图回答一个行业悬而未决的问题,也就是花了这么多钱做出来的世界模型,放到真实物理世界里,到底值不值?
目前来看,只要找到了正确的导向,具身智能就不怕路远。
具身智能的核心是“行动代价”
过去几年,具身世界模型沿着表征式、生成式、交互式三条路线持续迭代,各自都拿出了亮眼的技术突破。
表征路线能精准识别物体、解析空间关系,却没法直接转化为控制指令;
生成路线把虚拟场景做得越来越写实,像素精度一再刷新,却和真机的物理控制始终隔着一层;
交互式路线搭建起三维模拟环境,能在虚拟空间完成大量训练,却很难对齐真实世界的力触反馈与突发状况。
三条路线齐头并进,却面临着相同的问题,看似能力强,实际落地却很难。
核心问题,不是别的,出在评价体系的错位。
数字世界的大模型,生成内容出错可以撤回、重生成,代价几乎可以忽略,但物理世界的智能体完全不同,预判偏差会带来真实的损耗——机械手用力过猛捏碎商品,走位失误撞到障碍物,任务失败耽误工时,这些都是实打实的成本。
开放环境里的光线变化、物体移位、突发状况更是防不胜防,实验室里百发百中的演示,放到真实场景里成功率直接打对折都不稀奇。
于是,行业陷入了一种无效内卷,模型参数量越做越大,生成画面越来越精细,演示效果越来越惊艳,但真机落地的进度始终慢得像蜗牛。
没人算得清,多生成一亿个像素,到底能帮机器人多完成多少真实任务。
王晓刚的具身世界模型第一性原理,试图用评价标尺的纠正来解决问题。
这套判断的核心脉络是,世界模型的核心价值是从冗余的多模态输入里提炼高密度关键信息,锚定控制充分状态,在不确定的真实环境中最小化机器人的行动代价。
换个更通俗的说法,也就是,机器人不需要看清世界上所有细节,只要抓住那些能影响动作成败的关键信息就够了。
知道冰箱把手的位置、门的转轴角度、拉开需要的力度,远比看清冰箱门上的花纹、反光的光影重要,掌握的关键信息越充分,对动作边界的判断就越准,执行任务时的试错次数、时间成本、安全风险就越低。
这更像一套行业通用的算账标准,过去大家卷的是我能做到什么,现在开始算我做这件事要花多少成本。
对整个具身智能行业来说,这是一次重要的视角切换——从技术导向的能力竞赛,转向结果导向的价值核算。
顺着这个逻辑往下推,很多之前的行业共识都会松动,比如世界模型并非越逼真越好,如果增加的像素细节对动作控制没有帮助,那就是冗余信息,只会徒增算力开销。
原生统一架构,打碎能力割裂的天花板
Kairos 3.1开悟世界模型的整套设计,完全围绕“降低行动代价”展开。
和行业常见的多模块拼接方案不同,Kairos 3.1从设计之初就搭建了共享隐空间,依托混合Transformer架构与共享混合注意力机制,把视觉观测、语言指令、力触状态、策略轨迹这些多源数据,统一编码压缩进同一套表征体系里。三大能力共享同一套特征基础,信息在系统内无损流转,感知环境的同时就能同步推演动作后果、筛选最优路径,省去了模块间的数据传递与损耗。
落在具体能力上,每一项都紧扣抓关键信息、降行动成本的目标。
作为空间理解底座的ACE-BRAIN-0.5,已经拿下十二项全球基准测试SOTA,四项3D空间理解基准位列全球第一。
它的核心作用,就是从复杂环境里过滤无效信息,留下和动作执行直接相关的关键内容,空间层面精准识别物体位置与相对位姿,任务层面拆解长程任务为连贯步骤,状态层面全程追踪执行进度、定位失败节点。
比如,操作洗衣机,它不用识别洗衣机的品牌配色,只要精准定位舱门位置、开关角度、旋钮对应的模式关系,就足够支撑任务执行。
物理生成维度的Kairos-HomeWorld和Physx-omni,在场景渲染功能外,内置的30万套中国住宅平面图、5000个全屋仿真场景、8700个带完整物理属性的3D资产,最终服务的是机器人的“脑海推演”,所有物体严格遵循真实物理规则,机器人可以在平行空间里预演不同动作的结果,把试错成本留在虚拟世界,真机执行时直接输出最优方案。
动作预测能力,则直接把推演结果转化为行动指令。
面对同一个任务,模型会同步生成多条候选动作轨迹,预演各自的执行结果与行动代价,最终选出成功率最高、成本最低的方案输出。从桌面收纳到精细操作,再到全身协同的人形控制,这套预测体系可以支撑不同复杂度的真机任务。
更能体现落地诚意的,是端侧实时推理与自主反思闭环两项能力。
依托自研的KairosRT计算引擎,Kairos 3.1 8B模型在NVIDIA Jetson Thor平台上的推理延迟只有125毫秒,比同类型世界模型Cosmos3 Nano快出52倍,达到经典VLA模型的速度水平。
这个数字的真正意义,是让世界模型摆脱了对云端算力的依赖,可以直接部署在机器人本体上,实现低时延的实时控制——不用等云端传指令,真机就能直接响应环境变化,这是规模化落地的核心前提。
而开悟的自主反思闭环,则解决了“一次做不对怎么办”的问题。
真实场景永远有意外,任务评估器会全程核验执行状态,一旦操作失败,系统会自动定位问题节点,调用平行空间重新推演多组动作轨迹,筛选出优化方案后再次执行。
比如,开冰箱取水,三指操作发力不足失败后,系统会自主切换为四指操作方案,全程不需要人工干预。执行、评估、反思、优化,让机器人具备了自进化能力——干的活越多,积累的成败经验越多,执行效率就越高,行动代价就越低。
把技术账算成商业账
第一性原理成立的前提,是有足够的高密度信息喂给模型,这也是大晓同步发布环境式数据采集方案2.0的原因。
大晓这次还提出了一个信息密度定律:数据的价值不在数量堆叠,而在信息密度,能改变行动结果的信息,才是有价值的信息。
对应到数据层级里,L1、L2级数据只能支撑基础预训练,L3、L4级数据能拟合已知任务,只有融入三维力触觉、失败恢复轨迹、开放场景变量的L5级数据,才能让模型真正具备泛化与自进化能力。
这套2.0数采方案,就是奔着生产L5级数据去的。
ACE Ego Kit采集套件实现头、手、胸三位一体的全维度感知,力触觉手套的灵敏度达到0.01牛,二十余种异构传感器的同步误差控制在1毫秒内,精准捕捉真实交互中的物理因果信息。
ACE Data Engine标注平台用生成式4D动捕技术解决遮挡与快速移动难题,帧级准确率达到0.997。
ACE Ego Matrix作为开源标准底座,实现不同本体之间的数据对齐,打破硬件壁垒。
与此同时,大晓向全行业开源了L5级家居复杂任务数据集ACE-Data-0,把自己的高质量数据燃料共享出来,拉着整个行业往高密度数据的方向走。
技术最终要落到商业场景里验证价值。
这次大晓同步推出的三套行业解决方案,就是第一性原理在真实商业里的试金石。
面向即时零售的“晓满”方案,搭配履约机器人W1,能在75厘米的窄过道里稳定作业,打通机械控制、世界模型、订单仓储全链路,支持天级轻量化部署。目前已经落地烧卖购、快客达、中石油便利店等场景,规划一年内落地1000家零售点位。
对零售行业来说,拣货履约的人力成本、差错成本都是刚性支出,机器人能稳定顶上,就是看得见的价值。
面向酒店的“晓新”无人洗衣方案,瞄准酒店夜班洗衣招工难、成本高的痛点,机器人自主完成收、放、洗、叠全流程,适配不同星级的非标洗衣房。夜间人力成本高、订单集中的场景,恰恰是机器人替代性价比最高的地方。
面向开放场景的“晓途”四足作业方案,依托通用智能大脑实现“一脑多形”,适配不同形态的四足机器人,覆盖安防巡检、城市治理、文旅导览等场景,已经在漕河泾园区、上海滨江等地常态化运营。7×24小时不间断作业的特性,让它在公共空间运营里有明确的成本优势。
三套方案共享同一套技术底座,本质是用标准化的能力,去解决不同行业的共性痛点,把具身智能的落地成本打下来。
当行业开始算成本账,物理AI才真正开悟
从提出第一性原理,到推出一体化世界模型,再到配套数据方案、行业落地、统一评测标准,大晓这次WAIC的发布,是一整套完整的产业逻辑输出。
同期亮相的PHYSICAL IQ物智评测平台,由多家机构联合发起,汇聚二十余家高校与产业伙伴,正是要给行业建立统一的度量衡。过去各家世界模型各说各话,比参数、比画面、比特定场景下的SOTA,没有统一的落地能力评判标准。有了统一的评测体系,行业才能真正对齐目标,把力气花在能落地的方向上。
毕马威在最新的行业报告里,把原生一体化架构定义为世界模型最前沿的演进方向。从普通生成到因果干预,从离线评估到实时闭环,再到自我进化,世界模型的内禀推演深度逐级提升,而Kairos已经站在了自我进化的高阶方向上。
当然,现在就说具身智能已经跨过落地门槛,还为时尚早。
千店规模的落地目标能不能顺利达成,开放场景的复杂性能不能持续适配,自进化的速度能不能跟上商业需求,都还需要时间验证。
但不可否认的是,这次WAIC之后,具身世界模型的竞赛,已经悄悄换了赛道。过去大家比的是谁的模型更聪明、谁的画面更震撼,未来大家要算的,是谁的机器人干活更靠谱、谁的行动代价更低、谁能给客户创造实实在在的收益。
当整个行业开始正视物理世界的真实规则,开始为行动代价算账,物理AI的“开悟时刻”,或许才真正开始。
此内容为【智能相对论】原创,仅代表个人观点,未经授权,任何人不得以任何方式使用,包括转载、摘编、复制或建立镜像。
申请创业报道,分享创业好点子。点击此处,共同探讨创业新机遇!
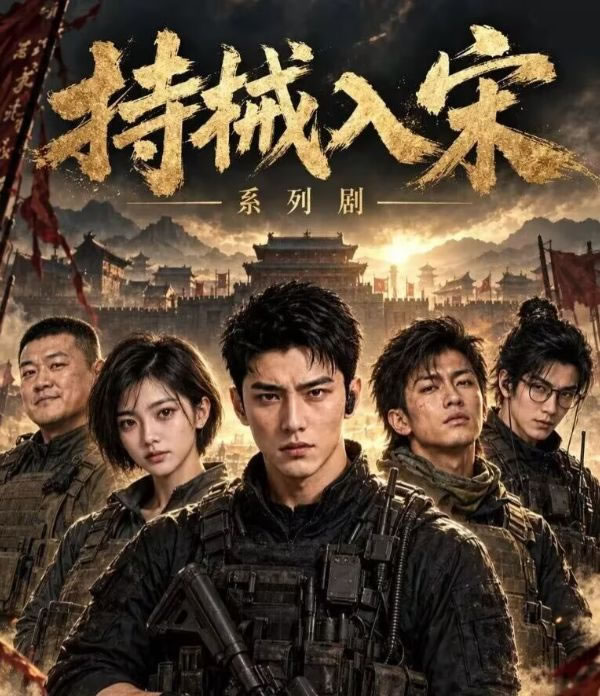
上周,我把AI短剧《持械入宋》的前十季全部看完了。说实话,有点出乎我的意料:(1)我以为一分钟一集很快就能看完,结果越看越上瘾,导致上周少更新了好多自媒体内容,耽误了好多工作。(2)以前我也看过不少AI生成的视频,人物变脸、动作穿帮、画面不连贯,基本看几分钟就没兴趣了。但《持械入宋》不一样。有时候我
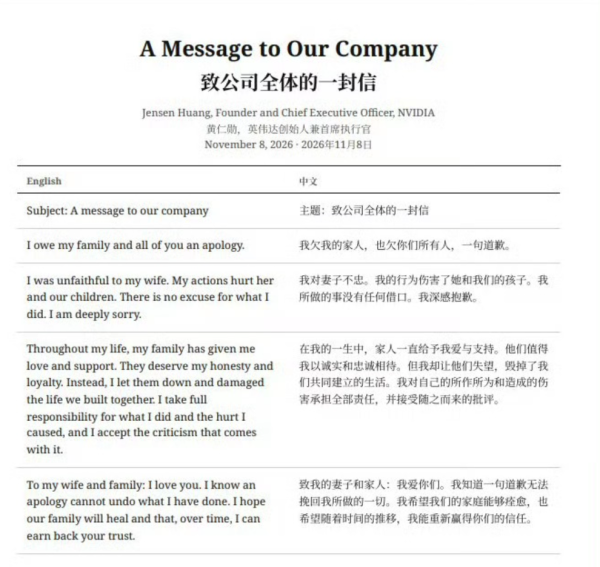
今年5月,黄仁勋穿着标志性皮衣在北京街头闲逛,吃炸酱面、喝蜜雪冰城的画面,曾让不少营销号津津乐道。那段时间,关于他的叙事几乎都绕不开一个关键词:专一。在这些营销号笔下,黄仁勋不只是手握万亿商业帝国的科技大佬,更是“纯爱战士”“亿万富豪里少见还守着原配的人”。故事确实有浪漫底色:17岁的黄仁勋在俄勒冈
文|智能相对论作者|李永华过去三年,行业对AI的主流想象,大体是“轻”的。一个对话框、一个超级入口、一套API,背后是轻资产、快扩张、高毛利的叙事,也是资本和大厂最愿意为之买单的故事。C端的个人智能体尤其如此,模型能力封装在产品里,用户调用即得,增长可以在很短时间内发生。但当AI从消费端走向产业端、
GCSAAI极客工作台(GCSASecVibeCode)由GCSA全球网络安全联盟与香港大学(HKU)联合研发,依托「香港大学×GCSAAI与网络安全研究所」,将模型原生安全、可信AI与AI驱动的自动化威胁防御等研究成果带入真实开发场景。产品结合攻防Agent与企业DLP,基于PiHarness提供
OpenAI于11月4日发布图像模型Images2.6,并在ChatGPT、Codex和API中同步上线。此次更新新增GIF动图功能:用户上传一张图片或输入一句提示词,即可生成循环播放的动画,出图速度比上一版提升50%。OpenAI表示,用户不再需要自己拼帧,也不必另开编辑软件。只需一句提示词,或上
Anthropic于11月5日公布了Claude的个人理财功能,并从当周起陆续向美国付费用户开放。用户绑定银行账户后,可直接查询账户余额和支出情况。目前Claude只能读取账户数据,不能直接进行银行转账。Anthropic在官网放了一段演示:从一句提问开始——“这个月钱花在哪儿了?”Claude将绑
文|智能相对论作者|陈泊丞Agent规模化干活,其实是一件很快的事。快到什么程度?Gartner2026年CIO及技术高管调查显示,超过60%的受访组织计划在未来两年内部署AIAgent。行业调研则进一步预测,到2027年,大型企业规模化部署Agent的比例将达到50%。到2030年,全球企业活跃A
最近,腾讯在AI应用和商业化探索方面,非常火热。先是推出的微信“绿泡泡”短剧,一度引发了外界对腾讯时间和字节时间的广泛关注;接着在最新举行的2026腾讯全球数字生态大会上,腾讯集团高级执行副总裁、云与智慧产业事业群CEO汤道生又在AI办公领域打出了一套组合拳。其中,有两招尤其引人关注:一个是推出了B
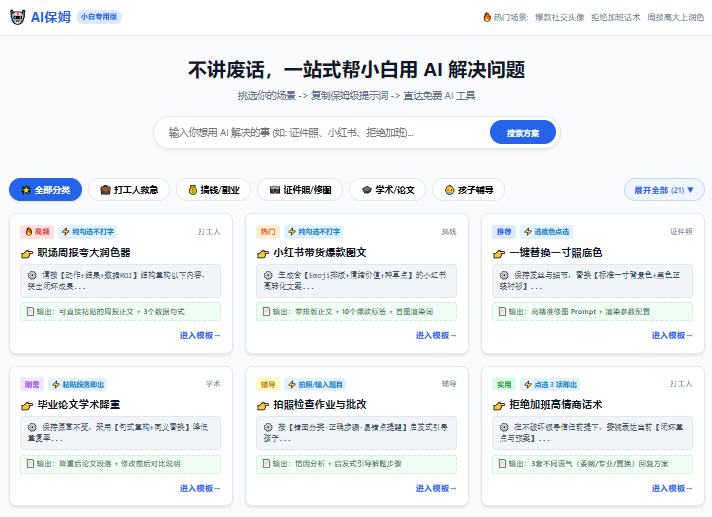
在“不谈AI就落伍”的今天,大语言模型早已普及。然而,对大量普通打工人、学生党来说,真正的尴尬依然很具体:输入“帮我写个周报”,AI吐出一堆空洞的“车轱辘话”;输入“帮我画个好看的头像”,AI输出的结果粗糙生硬;为了让它听懂一句人话,不得不翻几万字的“提示词调教指南”,折腾半天依然不得要领。“知道A
据OpenAI于11月5日发布的博文,该公司正式推出面向网络安全场景的专用模型GPT-6Cyber。OpenAI称,与上一代GPT-5.6Cyber相比,新模型在软件漏洞的发现、验证和修复方面均有明显提升,在ExploitGym测试中的得分相对提高约51%。ExploitGym基准主要考察模型能否利