文 | 智能相对论
作者 | 陈泊丞
今年以来,MoE模型成了AI行业的新宠儿。
一方面,越来越多的厂商在自家的闭源模型上采用了MoE架构。在海外,OpenAI的GPT-4、谷歌的Gemini、Mistral AI的Mistral、xAI的Grok-1等主流大模型都采用了MoE架构。
而在国内,昆仑万维推出的天工3.0、浪潮信息发布的源2.0-M32、通义千问团队发布的Qwen1.5-MoE-A2.7B、MiniMax全量发布的abab6、幻方量化旗下的DeepSeek发布的DeepSeek-MoE 16B等等也都属于MoE模型。
另一方面,在MoE模型被广泛应用的同时,也有部分厂商争先开源了自家的MoE模型。前不久,昆仑万维宣布开源2千亿参数的Skywork-MoE。而在此之前,浪潮信息的源2.0-M32、DeepSeek的DeepSeek-MoE 16B等,也都纷纷开源。
为什么MoE模型如此火爆,备受各大厂商的青睐?在开源的背后,MoE模型又是以什么样的优势使各大主流厂商成为其拥趸,试图作为改变AI行业的利器?
MoE模型火爆的背后: 全新的AI解题思路
客观来说,MoE模型的具体工作原理更接近中国的一句古语“术业有专攻”,通过把任务分门别类,然后分给多个特定的“专家”进行解决。
它的工作流程大致如此,首先数据会被分割为多个区块(token),然后通过门控网络技术(Gating Network)再把每组数据分配到特定的专家模型(Experts)进行处理,也就是让专业的人处理专业的事,最终汇总所有专家的处理结果,根据关联性加权输出答案。
当然,这只是一个大致的思路,关于门控网络的位置、模型、专家数量、以及MoE与Transformer架构的具体结合方案,各家方案都不尽相同,也逐渐成为各家竞争的方向——谁的算法更优,便能在这个流程上拉开MoE模型之间的差距。
像浪潮信息就提出了基于注意力机制的门控网络(Attention Router),这种算法结构的亮点在于可以通过局部过滤增强的注意力机制(LFA, Localized Filtering-based Attention),率先学习相邻词之间的关联性,然后再计算全局关联性的方法,能够更好地学习到自然语言的局部和全局的语言特征,对于自然语言的关联语义理解更准确,从而更好地匹配专家模型,保证了专家之间协同处理数据的水平,促使模型精度得以提升。
基于注意力机制的门控网络(Attention Router)
抛开目前各家厂商在算法结构上的创新与优化不谈,MoE模型这种工作思路本身所带来的性能提升就非常显著——通过细粒度的数据分割和专家匹配,从而实现了更高的专家专业化和知识覆盖。
这使得MoE模型在处理处理复杂任务时能够更准确地捕捉和利用相关知识,提高了模型的性能和适用范围。因此,「智能相对论」尝试了去体验天工3.0加持的AI搜索,就发现对于用户较为笼统的问题,AI居然可以快速的完成拆解,并给出多个项目参数的详细对比,属实是强大。
天工AI搜索提问“对比一下小米su7和特斯拉model3”所得出的结果
由此我们可以看到,AI在对比两款车型的过程中,巧妙地将这一问题拆解成了续航里程、动力性能、外观设计、内饰设计、智能化与自动驾驶、市场表现与用户口碑、价格等多个项目,分别处理得出较为完整且专业的答案。
这便是“术业有专攻”的优势——MoE模型之所以受到越来越多厂商的关注,首要的关键就在于其所带来的全新解决问题的思路促使模型的性能得到了较为显著的提高。特别是伴随着行业复杂问题的涌现,这一优势将使得MoE模型得到更广泛的应用。
各大厂商争先开源MoE模型: 解决AI算力荒的另一条路径
开源的意义在于让MoE模型更好的普及。那么,对于市场而言,为什么要选择MoE模型?
抛开性能来说,MoE模型更突出的一点优势则在于算力效率的提升。
DeepSeek-MoE 16B在保持与7B参数规模模型相当的性能的同时,只需要大约40%的计算量。而37亿参数的源2.0-M32在取得与700亿参数LLaMA3相当性能水平的同时,所消耗的算力也仅为LLaMA3的1/19。
也就意味着,同样的智能水平,MoE模型可以用更少的计算量和内存需求来实现。这得益于MoE模型在应用中并非要完全激活所有专家网络,而只需要激活部分专家网络就可以解决相关问题,很好避免了过去“杀鸡用牛刀”的尴尬局面。
举个例子,尽管DeepSeek-MoE 16B的总参数量为16.4B,但每次推理只激活约2.8B的参数。与此同时,它的部署成本较低,可以在单卡40G GPU上进行部署,这使得它在实际应用中更加轻量化、灵活且经济。
在当前算力资源越来越紧张的“算力荒”局面下,MoE模型的出现和应用可以说为行业提供了一个较为现实且理想的解决方案。
更值得一提的是,MoE模型还可以轻松扩展到成百上千个专家,使得模型容量极大增加,同时也允许在大型分布式系统上进行并行计算。由于各个专家只负责一部分数据处理,因此在保持模型性能的同时,又能显著降低了单个节点的内存和计算需求。
如此一来,AI能力的普惠便有了非常可行的路径。这样的特性再加上厂商开源,将促使更多中小企业不需要重复投入大模型研发以及花费过多算力资源的情况下便能接入AI大模型,获取相关的AI能力,促进技术普及和行业创新。
当然,在这个过程中,MoE模型厂商们在为市场提供开源技术的同时,也有机会吸引更多企业转化成为付费用户,进而走通商业化路径。毕竟,MoE模型的优势摆在眼前,接下来或许将有更多的企业斗都会尝试新的架构来拓展AI能力,越早开源越能吸引更多市场主体接触并参与其中。
但是,开源最关键的优势还是在于MoE模型对当前算力问题的解决。或许,随着MoE模型被越来越多的企业所接受并应用,行业在获得相应AI能力的同时也不必困顿于算力资源紧张的问题了。
写在最后
MoE大模型作为当前人工智能领域的技术热点,其独特的架构和卓越的性能为人工智能的发展带来了新的机遇。不管是应用还是开源,随着技术的不断进步和应用场景的不断拓展,MoE大模型有望在更多领域发挥巨大的潜力。
MoE模型的本质在于为AI行业的发展提供了两条思路,一是解决应用上的性能问题,让AI有了更强大的解题思路。二是解决算力上的欠缺问题,让AI有了更全面的发展空间。由此来看MoE模型能成为行业各大厂商的宠儿,也是水到渠成的事情。
*本文图片均来源于网络
此内容为【智能相对论】原创,
仅代表个人观点,未经授权,任何人不得以任何方式使用,包括转载、摘编、复制或建立镜像。
部分图片来自网络,且未核实版权归属,不作为商业用途,如有侵犯,请作者与我们联系。
•AI产业新媒体;
•澎湃新闻科技榜单月度top5;
•文章长期“霸占”钛媒体热门文章排行榜TOP10;
•著有《人工智能 十万个为什么》
•【重点关注领域】智能家电(含白电、黑电、智能手机、无人机等AIoT设备)、智能驾驶、AI+医疗、机器人、物联网、AI+金融、AI+教育、AR/VR、云计算、开发者以及背后的芯片、算法等。
申请创业报道,分享创业好点子。点击此处,共同探讨创业新机遇!

文/道哥美国设计软件公司Figma近期在纽约证券交易所挂牌上市,首日即上演“狂飙”行情——发行价定每股33美元,开盘报价85美元,较发行价翻倍。首日收报115.50美元,较发行价大涨约250%,市值飙升至近670亿美元,创下近30年来同等规模美股IPO的最大单日涨幅纪录。然而,随着短线资金获利了结,

文/一灯来源/节点财经在当前无人敢缺席的AI军备竞赛中,巨头们一面为巨额的资本支出焦虑,一面又向市场勾勒着未来的宏伟蓝图。在各家动辄千亿级投入的背景下,市场迫切需要一份关于AI回报价值的有力证明。而腾讯,率先给出了答卷。8月13日,腾讯控股发布2025年第二季度财报。尽管资本开支同比剧增119%,达

文/二风来源/节点财经2025年的硅谷,一场没有硝烟的战争正以前所未有的烈度上演。这场战争的核心武器不是代码或芯片,而是人——那些全球仅有数千名、能够构建未来人工智能基础模型的顶尖大脑。在这场激烈的人才争夺战中,Meta及其首席执行官马克·扎克伯格(MarkZuckerberg)正扮演着最具侵略性的


文/道哥大举裁员、清空账号、国内IP无法访问——曾被誉为“中国AIAgent希望之星”的Manus,在估值飙至5亿美元的高光时刻“闪离”中国市场。近日,Manus“裁员、出走”的消息在媒体端大量发酵。消息称,Manus公司总部将由中国迁至新加坡,其国内团队也将大幅裁撤——原有120人规模团队除40余
今天央视财经报道了一组能标记行业节奏的数字:物理AI头部客户的训练数据需求,从去年十万小时级跳到了今年百万小时级,增幅接近10倍。这里的"小时"不是图文数据,而是机器人在真实环境里跑动、抓取、碰撞、避障的连续记录。数据从哪来?仿真合成加上人类视频,两条路同时在补。宇树科技创始人王兴兴在进博会期间给出
11月9日,Anthropic正式发布ClaudeFable5.2和ClaudeMythos5.2两款新模型。Fable面向普通用户,内置网络安全与生物安全防护;Mythos则只向通过审核的专业机构开放,处理高风险场景。两款基于同一底层架构,区别在于安全边界和应用准入。官方还展示了一组由千个智能体协
11月9日,阿里千问办公2.0正式发布。这次升级有一个值得关注的变化:它不再只是服务个人的AI助手,而是开始支持多人和Agent共同协作,可以把AI直接拉进工作群,让它参与团队任务。就在几天前,11月6日,华为小艺Work正式版上线鸿蒙电脑应用商店。10月30日,腾讯WorkBuddy企业版宣布四项
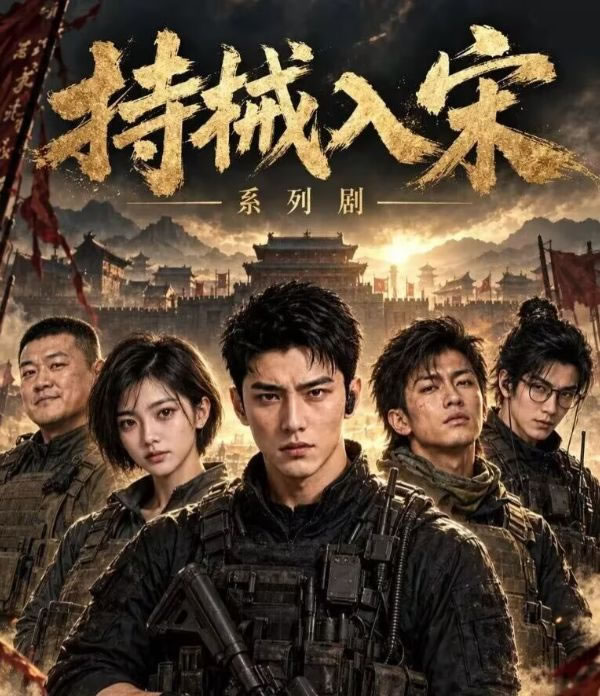
上周,我把AI短剧《持械入宋》的前十季全部看完了。说实话,有点出乎我的意料:(1)我以为一分钟一集很快就能看完,结果越看越上瘾,导致上周少更新了好多自媒体内容,耽误了好多工作。(2)以前我也看过不少AI生成的视频,人物变脸、动作穿帮、画面不连贯,基本看几分钟就没兴趣了。但《持械入宋》不一样。有时候我
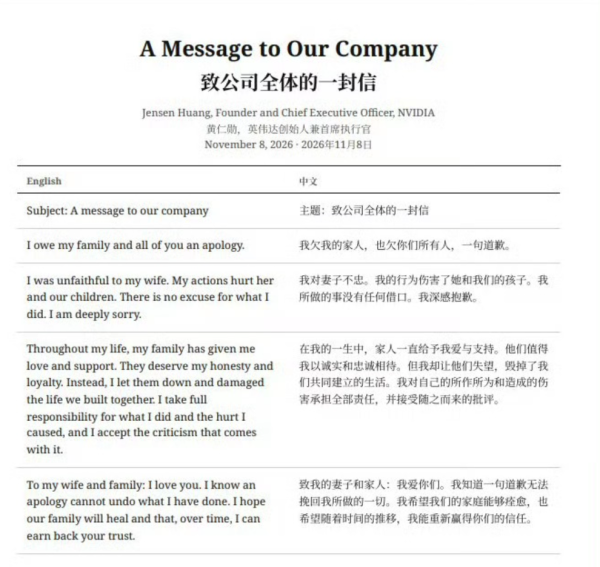
今年5月,黄仁勋穿着标志性皮衣在北京街头闲逛,吃炸酱面、喝蜜雪冰城的画面,曾让不少营销号津津乐道。那段时间,关于他的叙事几乎都绕不开一个关键词:专一。在这些营销号笔下,黄仁勋不只是手握万亿商业帝国的科技大佬,更是“纯爱战士”“亿万富豪里少见还守着原配的人”。故事确实有浪漫底色:17岁的黄仁勋在俄勒冈
文|智能相对论作者|李永华过去三年,行业对AI的主流想象,大体是“轻”的。一个对话框、一个超级入口、一套API,背后是轻资产、快扩张、高毛利的叙事,也是资本和大厂最愿意为之买单的故事。C端的个人智能体尤其如此,模型能力封装在产品里,用户调用即得,增长可以在很短时间内发生。但当AI从消费端走向产业端、
GCSAAI极客工作台(GCSASecVibeCode)由GCSA全球网络安全联盟与香港大学(HKU)联合研发,依托「香港大学×GCSAAI与网络安全研究所」,将模型原生安全、可信AI与AI驱动的自动化威胁防御等研究成果带入真实开发场景。产品结合攻防Agent与企业DLP,基于PiHarness提供
OpenAI于11月4日发布图像模型Images2.6,并在ChatGPT、Codex和API中同步上线。此次更新新增GIF动图功能:用户上传一张图片或输入一句提示词,即可生成循环播放的动画,出图速度比上一版提升50%。OpenAI表示,用户不再需要自己拼帧,也不必另开编辑软件。只需一句提示词,或上
Anthropic于11月5日公布了Claude的个人理财功能,并从当周起陆续向美国付费用户开放。用户绑定银行账户后,可直接查询账户余额和支出情况。目前Claude只能读取账户数据,不能直接进行银行转账。Anthropic在官网放了一段演示:从一句提问开始——“这个月钱花在哪儿了?”Claude将绑
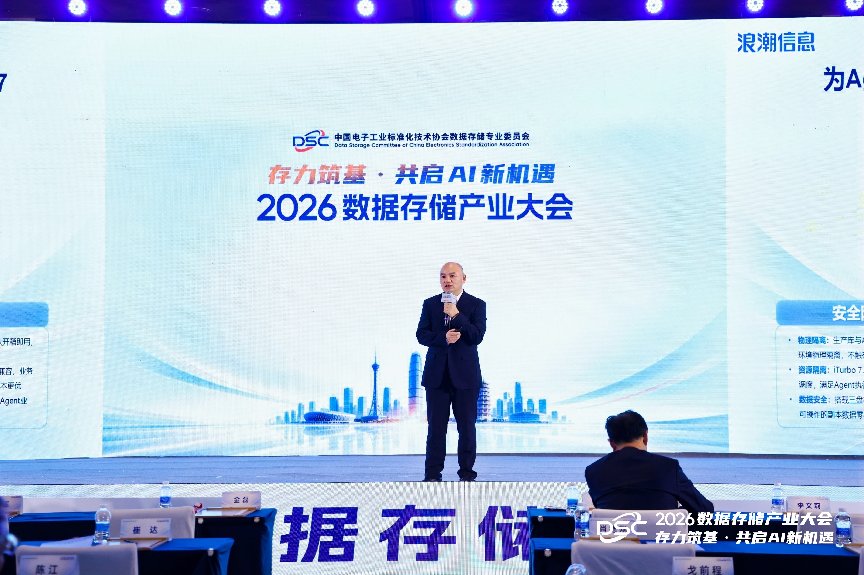
文|智能相对论作者|陈泊丞Agent规模化干活,其实是一件很快的事。快到什么程度?Gartner2026年CIO及技术高管调查显示,超过60%的受访组织计划在未来两年内部署AIAgent。行业调研则进一步预测,到2027年,大型企业规模化部署Agent的比例将达到50%。到2030年,全球企业活跃A