9月24日,2025云栖大会现场,阿里云CTO周靖人接连发布了七款大模型技术产品。七款技术产品覆盖语言、语音、视觉、多模态、代码等模型领域,在模型智能水平、Agent工具调用以及Coding能力、深度推理、多模态等方面均实现突破。
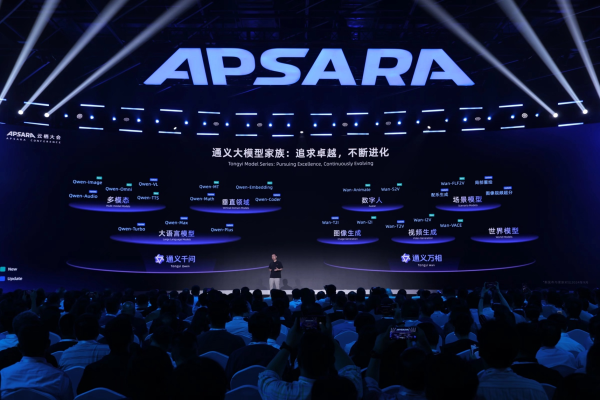
在大语言模型中,阿里通义旗舰模型Qwen3-Max全新亮相,性能超过GPT5、Claude Opus 4等,跻身全球前三。Qwen3-Max包括指令(Instruct)和推理(Thinking)两大版本,其预览版已在 Chatbot Arena 排行榜上位列第三,正式版性能可望再度实现突破。
Qwen3-Max是通义千问家族中最大、最强的基础模型,预训练数据量达36T,总参数超过万亿,拥有极强的Coding编程能力和Agent工具调用能力。在大模型用Coding解决真实世界问题的SWE-Bench Verified测试中,Instruct版本斩获69.6分,位列全球第一梯队;在聚焦Agent工具调用能力的Tau2-Bench测试中,Qwen3-Max取得突破性的74.8分,超过Claude Opus4和DeepSeek-V3.1。Qwen3-Max推理模型也展现出非凡性能,结合工具调用和并行推理技术,其推理能力创下新高,尤其在聚焦数学推理的AIME 25和HMMT测试中,均达到突破性的满分100分,为国内首次。
下一代基础模型架构Qwen3-Next及系列模型正式发布,模型总参数80B仅激活 3B ,性能即可媲美千问3旗舰版235B模型,实现模型计算效率的重大突破。Qwen3-Next针对大模型在上下文长度和总参数两方面不断扩展(Scaling)的未来趋势而设计,创新改进采用了混合注意力机制、高稀疏度 MoE 结构、多 token 预测(MTP)机制等核心技术,模型训练成本较密集模型Qwen3-32B大降超90%,长文本推理吞吐量提升10倍以上,为未来大模型的训练和推理的效率设立了全新标准。
在专项模型方面,千问编程模型Qwen3-Coder重磅升级。新的Qwen3-Coder与Qwen Code、Claude Code系统联合训练,应用效果显著提升,推理速度更快,代码安全性也显著提升。Qwen3-Coder此前就广受开发者和企业好评,代码生成和补全能力极强,可一键完成完整项目的部署和问题修复,开源后调用量曾在知名API调用平台OpenRouter上激增1474%,位列全球第二。
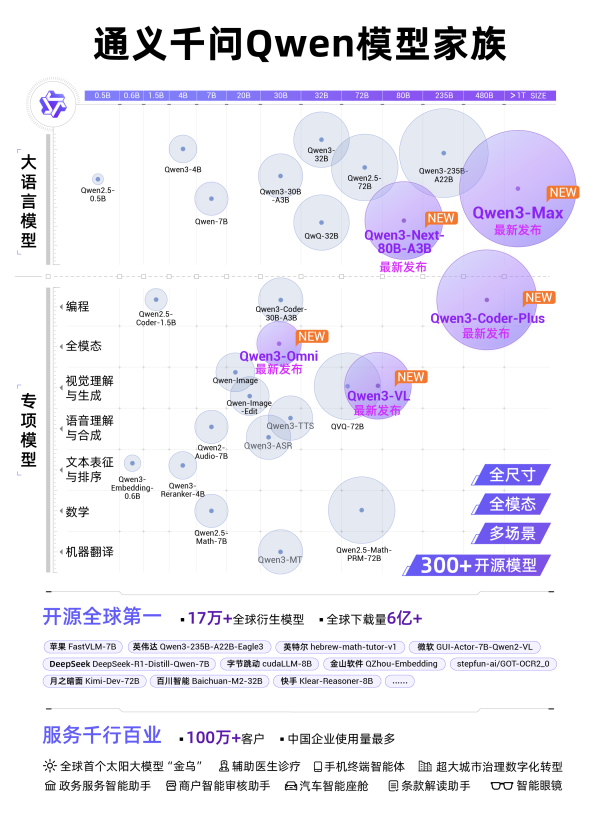
通义千问Qwen模型家族图
在多模态模型中,千问备受期待的视觉理解模型Qwen3-VL重磅开源,在视觉感知和多模态推理方面实现重大突破,在32项核心能力测评中超过Gemini2.5-Pro和GPT5。Qwen3-VL拥有极强的视觉智能体和视觉Coding能力,不仅能看懂图片,还能像人一样操作手机和电脑,自动完成许多日常任务。输入一张图片,Qwen3-VL可自行调用agent工具放大图片细节,通过更仔细的观察分析,推理出更好的答案;看到一张设计图,Qwen3-VL 就能生成Draw.io/HTML/CSS/JS 代码,“所见即所得”地完成视觉编程。此外,Qwen3-VL还升级了3D Grounding(3D检测)能力,为具身智能夯实基础;扩展支持百万tokens上下文,视频理解时长扩展到2小时以上。
全模态模型Qwen3-Omni惊喜亮相,音视频能力狂揽32项开源最佳性能SOTA,可像人类一样听说写,应用场景广泛,未来可部署于车载、智能眼镜和手机等。用户还可设定个性化角色、调整对话风格,打造专属的个人IP。类似于人类婴儿一出生就全方位感知世界,Qwen3-Omni一开始就加入了“听”、“说”、“写”多模态混合训练。在预训练过程中,Qwen3-Omni采用了混合单模态和跨模态数据。此前,模型在混合训练后,各个功能会相互掣肘甚至降智,比如音频理解能力提升,文字理解能力反而降低了。但Qwen3-Omni在实现强劲音频与音视频能力的同时,单模态文本与图像性能均保持稳定,这是业内首次实现这一训练效果。
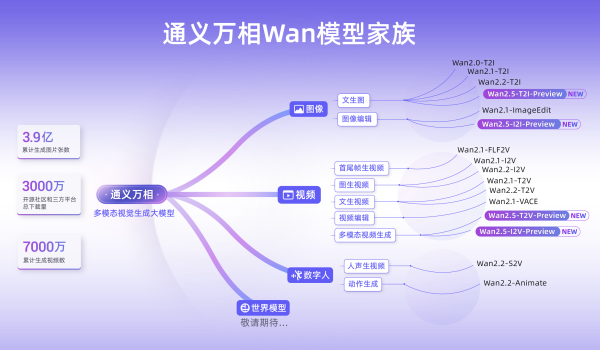
通义万相Wan模型家族图
通义万相是通义大模型家族中的视觉基础模型,此次推出Wan2.5-preview系列模型,涵盖文生视频、图生视频、文生图和图像编辑四大模型。通义万相2.5视频生成模型能生成和画面匹配的人声、音效和音乐BGM,首次实现音画同步的视频生成能力,进一步降低电影级视频创作的门槛。通义万相2.5视频生成时长从5秒提升至10秒,支持24帧每秒的1080P高清视频生成,并进一步提升模型指令遵循能力。此次,通义万相2.5还全面升级了图像生成能力,可生成中英文文字和图表,支持图像编辑功能,输入一句话即可完成P图。
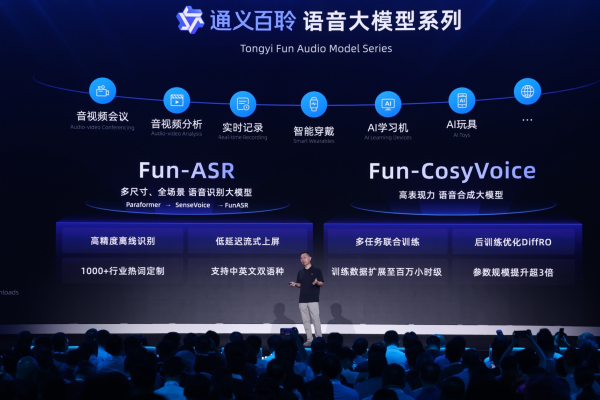
阿里云CTO周靖人发布通义百聆
此次云栖大会上,通义大模型家族还迎来了全新的成员——语音大模型通义百聆。百聆新发布了语音识别大模型Fun-ASR和语音合成大模型Fun-CosyVoice。Fun-ASR基于数千万小时真实语音数据训练而成,具备强大的上下文理解能力与行业适应性;Fun-CosyVoice可提供上百种预制音色,可以用于客服、销售、直播电商、消费电子、有声书、儿童娱乐等场景。
从0.5B到超万亿,包含三百个大模型的通义大模型家族覆盖“全尺寸”,囊括LLM、编程、图像、语音、视频等“全模态”,可满足从智能终端到云上的多场景需求。自2023年开源第一款模型以来,通义大模型在全球下载量突破6亿次,衍生模型突破17万个,已发展成为全球第一开源模型。除了惠及AI开发者,通义衍生模型的开发机构还覆盖海内外国知名企业,包括苹果、英伟达、微软、DeepSeek和字节跳动等。截至目前,通义大模型已服务超100万客户。沙利文报告显示,2025年上半年,在中国企业级大模型调用市场中,通义位列第一。
申请创业报道,分享创业好点子。点击此处,共同探讨创业新机遇!
今天央视财经报道了一组能标记行业节奏的数字:物理AI头部客户的训练数据需求,从去年十万小时级跳到了今年百万小时级,增幅接近10倍。这里的"小时"不是图文数据,而是机器人在真实环境里跑动、抓取、碰撞、避障的连续记录。数据从哪来?仿真合成加上人类视频,两条路同时在补。宇树科技创始人王兴兴在进博会期间给出
11月9日,Anthropic正式发布ClaudeFable5.2和ClaudeMythos5.2两款新模型。Fable面向普通用户,内置网络安全与生物安全防护;Mythos则只向通过审核的专业机构开放,处理高风险场景。两款基于同一底层架构,区别在于安全边界和应用准入。官方还展示了一组由千个智能体协
11月9日,阿里千问办公2.0正式发布。这次升级有一个值得关注的变化:它不再只是服务个人的AI助手,而是开始支持多人和Agent共同协作,可以把AI直接拉进工作群,让它参与团队任务。就在几天前,11月6日,华为小艺Work正式版上线鸿蒙电脑应用商店。10月30日,腾讯WorkBuddy企业版宣布四项
上周,我把AI短剧《持械入宋》的前十季全部看完了。说实话,有点出乎我的意料:(1)我以为一分钟一集很快就能看完,结果越看越上瘾,导致上周少更新了好多自媒体内容,耽误了好多工作。(2)以前我也看过不少AI生成的视频,人物变脸、动作穿帮、画面不连贯,基本看几分钟就没兴趣了。但《持械入宋》不一样。有时候我
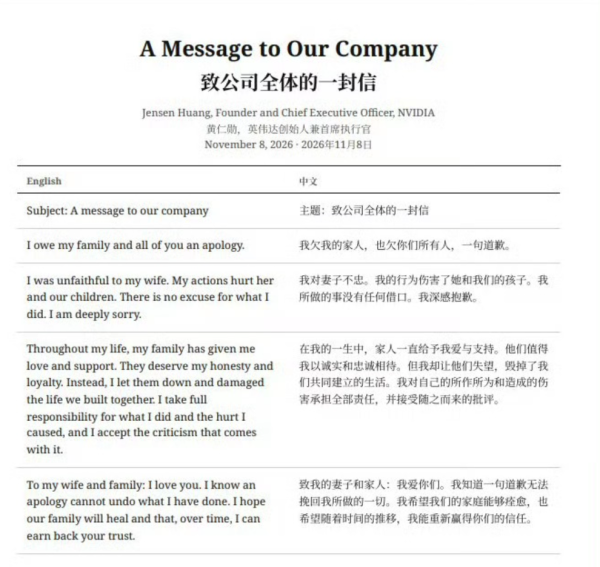
今年5月,黄仁勋穿着标志性皮衣在北京街头闲逛,吃炸酱面、喝蜜雪冰城的画面,曾让不少营销号津津乐道。那段时间,关于他的叙事几乎都绕不开一个关键词:专一。在这些营销号笔下,黄仁勋不只是手握万亿商业帝国的科技大佬,更是“纯爱战士”“亿万富豪里少见还守着原配的人”。故事确实有浪漫底色:17岁的黄仁勋在俄勒冈
文|智能相对论作者|李永华过去三年,行业对AI的主流想象,大体是“轻”的。一个对话框、一个超级入口、一套API,背后是轻资产、快扩张、高毛利的叙事,也是资本和大厂最愿意为之买单的故事。C端的个人智能体尤其如此,模型能力封装在产品里,用户调用即得,增长可以在很短时间内发生。但当AI从消费端走向产业端、
GCSAAI极客工作台(GCSASecVibeCode)由GCSA全球网络安全联盟与香港大学(HKU)联合研发,依托「香港大学×GCSAAI与网络安全研究所」,将模型原生安全、可信AI与AI驱动的自动化威胁防御等研究成果带入真实开发场景。产品结合攻防Agent与企业DLP,基于PiHarness提供
OpenAI于11月4日发布图像模型Images2.6,并在ChatGPT、Codex和API中同步上线。此次更新新增GIF动图功能:用户上传一张图片或输入一句提示词,即可生成循环播放的动画,出图速度比上一版提升50%。OpenAI表示,用户不再需要自己拼帧,也不必另开编辑软件。只需一句提示词,或上
Anthropic于11月5日公布了Claude的个人理财功能,并从当周起陆续向美国付费用户开放。用户绑定银行账户后,可直接查询账户余额和支出情况。目前Claude只能读取账户数据,不能直接进行银行转账。Anthropic在官网放了一段演示:从一句提问开始——“这个月钱花在哪儿了?”Claude将绑
文|智能相对论作者|陈泊丞Agent规模化干活,其实是一件很快的事。快到什么程度?Gartner2026年CIO及技术高管调查显示,超过60%的受访组织计划在未来两年内部署AIAgent。行业调研则进一步预测,到2027年,大型企业规模化部署Agent的比例将达到50%。到2030年,全球企业活跃A